Het afgelopen jaar bouwde Warpnet een autonome pentestoplossing die we inmiddels dagelijks inzetten in onze opdrachten: PenLocal.
Kan een LLM doen wat een ethisch hacker doet, binnen dezelfde kaders en met hetzelfde bewijs? Met dat onderzoek begonnen onze securityspecialisten vorig jaar. Inmiddels plant PenLocal zelf de stappen van een pentest, voert ze uit in een afgeschermde omgeving en controleert zijn eigen bevindingen. Onze pentesters houden de regie. Zij sturen bij, keuren risicovolle stappen goed en doen waar een mens nog altijd beter in is: bepalen wat er voor jouw organisatie echt toe doet.
In september wilden we weten of dat ook lukt met een model dat we zelf draaien. We lieten vier modellen dezelfde vier applicaties testen. Een lokaal model op onze eigen grafische kaarten kwam met drie samengevoegde runs op 87,4%, dezelfde score als het duurste cloudmodel in één run, voor $7,74 in plaats van $132,19.
Bekende kwetsbaarheden worden binnen uren misbruikt
Aanvallers zetten een gepubliceerde kwetsbaarheid tegenwoordig binnen uren om in een werkende aanval. AI versnelt en vergroot het misbruik van deze dreigingen. NCTV, NCSC, AIVD, MIVD, OM, CIO Rijk en politie waarschuwden op 24 september 2026 in een gezamenlijk statement dat kwetsbaarheden door AI steeds sneller worden opgespoord en misbruikt. Volgens hen hebben aanvallers daar geen frontier-model voor nodig. Bestaande, makkelijk toegankelijke modellen volstaan.
Toch testen veel organisaties hun beveiliging nog maar één keer per jaar. Dat geeft één dag inzicht en 364 dagen waarin nieuwe code ongetest blijft.
Testen met broncode wordt de standaard
Bij een handmatige pentest is het meelezen in de broncode een kostenpost. Elk extra document en elke extra regel broncode kosten een pentester extra uren, die terugkomen op de offerte. Voor een AI-agent ligt dat anders. Lezen is het goedkoopste wat een LLM doet, en alles wat het leest kan het gebruiken om gerichter aan te vallen.
In de finale van DARPA’s AI Cyber Challenge in augustus 2025 doorzochten AI-systemen ruim 54 miljoen regels code. Ze vonden 54 van de 63 ingebouwde kwetsbaarheden en 18 echte, voor gemiddeld ongeveer $152 per taak. Daarom test PenLocal standaard met de broncode erbij, als je die beschikbaar stelt. In dezelfde doorlooptijd bekijken we zo een groter deel van je applicatie en proberen we op elk onderdeel meer soorten aanvallen uit.
Ook de uurprijs verschilt. Onderzoekers van onder meer Stanford lieten een AI-agent en tien professionele pentesters los op een universiteitsnetwerk met ongeveer 8.000 hosts. De agent eindigde als tweede van elf deelnemers en kostte in sommige configuraties minder dan een derde van het uurtarief van een pentester.
Een LLM is alleen het brein
Een LLM kan op zichzelf eigenlijk verrassend weinig. Het leest en het schrijft tekst. Het voert geen commando’s uit, vergeet in een lang gesprek wat het eerder zag en kan niet nagaan of zijn eigen antwoord klopt. Om er een pentest mee te doen heb je een systeem om het model heen nodig dat bepaalt wat het model te zien krijgt, wat het mag uitvoeren en wat er met zijn antwoord gebeurt. Dat systeem heet de harness.
Kwetsbaarheden vinden is voor een groot deel zoekwerk. Een krachtig model mist een lek alsnog als niemand het de juiste kant op stuurt, als het eerdere bewijs kwijt is of als niemand de bevinding controleert. Een LLM is bovendien niet-deterministisch: dezelfde opdracht levert bij elke run een andere uitkomst op, dus wat de ene run mist, vindt de andere soms wel. Daarom staken onze specialisten het afgelopen jaar het meeste werk niet in het LLM, maar in de harness van PenLocal.
De harness van PenLocal heeft vijf onderdelen:
- Planner: maakt van een voorstel voor de scope een dreigingsmodel en verdeelt dat in taken per onderdeel en per aanvalsklasse. Jij weet daardoor precies wat we hebben getest, en wat niet.
- Sandbox: elke taak draait in een eigen afgeschermde omgeving, gescheiden van de rest van ons platform. De enige netwerkverbinding naar jouw systemen loopt via één poort. Die dwingt de scope en een verbodslijst af en legt risicovolle stappen eerst voor aan een pentester. Een andere route naar je systemen heeft PenLocal niet.
- Auditlog: legt elk commando met de volledige uitvoer vast. Elke bevinding is zo terug te voeren op wat er werkelijk gebeurde.
- Verifier: een ander model dan het model dat de bevinding deed, toetst elke bevinding aan het auditlog. Een kwetsbaarheid die het model heeft verzonnen, haalt je rapport niet.
- Beoordelaar: filtert dubbele bevindingen, weegt de ernst en zoekt ketens: losse zwakke plekken die samen een groot risico vormen.
Model en harness zijn bij ons gescheiden. Daardoor kunnen we elk model aan PenLocal koppelen: een frontier-model in de cloud of een kleiner model op onze eigen grafische kaarten. Per opdracht kiezen we het model dat past bij jouw eisen aan prijs, snelheid en vertrouwelijkheid.
Dertig jaar pentestervaring in de harness
Een model aan een terminal koppelen kost tegenwoordig een middag. Het werk zit ergens anders: in de duizenden kleine keuzes in de harness. Welke aanvallen probeer je waar? Wat telt als bewijs? Welke stap gebeurt nooit zonder akkoord van een mens? Wanneer worden losse kleine bevindingen samen een kritiek risico? Die beslissingen komen niet uit een model. Ze komen uit dertig jaar ervaring.
Warpnet is een onafhankelijk Nederlands securitybedrijf en doet dit werk sinds 1996. Ons team ethisch hackers vond in die jaren tienduizenden kwetsbaarheden. Die ervaring zit in de manier waarop de agents een applicatie opdelen en aanpakken en in de manier waarop de verifier bevindingen beoordeelt.
Een LLM is het zwakst in twee fases, en die laten we bewust niet aan de machine over: het vooroverleg met jou en het vaststellen van het dreigingsmodel. Het vindt een technisch correcte maar onschuldige kwetsbaarheid net zo makkelijk als een kwetsbaarheid die er echt toe doet, het weet niet welke van de twee jouw organisatie raakt. In het onderzoek van Stanford leverde de agent ook meer false positives in dan de menselijke testers. Wat er in je rapport komt, beoordelen daarom onze pentesters.
Gevoelige gegevens blijven in Groningen
Een pentest bevat per definitie het gevoeligste materiaal dat een organisatie bezit: broncode, testaccounts, interne systemen en de kwetsbaarheden die daarin zitten. Dat materiaal naar een externe AI-leverancier sturen is voor veel bedrijven geen optie, en voor ons ook niet (hierover schreven we eerder al een artikel).
Daarom investeerden we het afgelopen jaar in een eigen AI-server, met ruim voldoende werkgeheugen en NVIDIA RTX PRO 6000 Blackwell-kaarten, elk met 96 GB VRAM. De server staat in ons eigen deel van een datacenter in Groningen.
Op die server draaien we taalmodellen in eigen beheer. Alle AI-toepassingen van Warpnet gebruiken deze lokale AI: de autonome pentests van PenLocal, de code reviews, de controle van bevindingen en hulp bij het schrijven van rapporten. Wil je dat we voor jouw opdracht een frontier-model in de cloud inzetten? Dan kan dat nog altijd. Maar standaard draait alles lokaal.
Dat je data binnenblijft, dwingen we op vier manieren technisch af:
- Geen directe lijn naar een leverancier. De werkplek van een pentester praat altijd met ons eigen platform, nooit rechtstreeks met een leverancier.
- Een nieuwe sandbox per taak. Elke taak draait in een afgeschermde sandbox die alleen de systemen in scope kan bereiken. Na afloop vernietigen we die sandbox.
- Een noodrem. Raakt een agent iets waar hij niet hoort te komen? Dan stopt de test direct.
- Een volledige auditlog. Elke actie van de AI is terug te lezen.
Waar de data heen mag, leggen we per opdracht samen met jou vast. Daar kiezen we het juiste model bij.
Lokale modellen tegenover frontier-modellen
De grote frontier-modellen uit de cloud zijn indrukwekkend, en de aanname is dat alleen zij goed genoeg zijn voor serieus pentestwerk. Wij wilden dat meten. We lieten vier modellen los op vier realistische pentestdoelen van Warpnet: applicaties met kwetsbaarheden uit de praktijk.
Vooraf stelden onze pentesters op basis van de broncode een antwoordsleutel op met 35 kwetsbaarheden, gewogen naar ernst. Een kritieke kwetsbaarheid telt daarin vijf keer zo zwaar als slordig ingestelde bestandsrechten. Elk model kreeg dezelfde opdracht, dezelfde tools en dezelfde harness. De lokale modellen draaiden drie keer per applicatie op onze eigen server in Groningen, de cloudmodellen één keer.
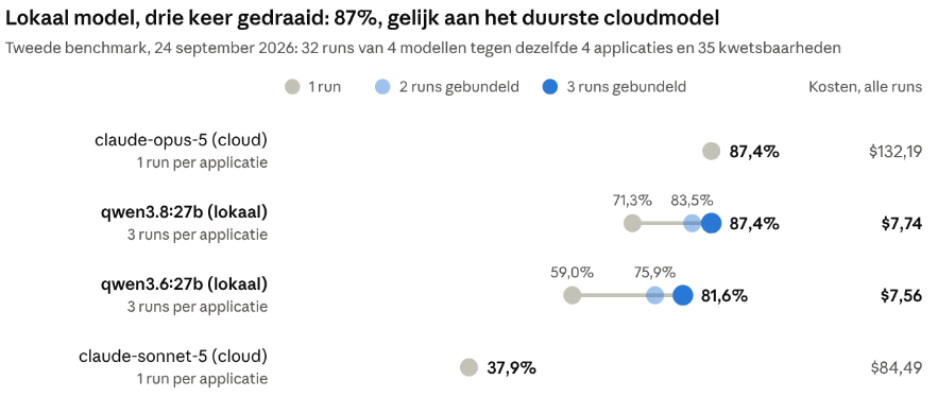
Het lokale qwen3.8 kwam met drie samengevoegde runs op 87,4%, dezelfde score als claude-opus-5 in één run. De twaalf runs van qwen3.8 kostten samen $7,74. De vier runs van claude-opus-5 kostten $132,19, ruim zeventien keer zoveel. Het oudere qwen3.6 kwam samengevoegd op 81,6%.
Drie runs vinden meer dan één
De uitkomst van een LLM verschilt per run en dat verschil is groot. Tien kwetsbaarheden werden door slechts één van de drie runs gevonden. Het sprekendste voorbeeld: qwen3.6 vond in de ene run 16% van de kwetsbaarheden in een applicatie en in een andere run 95%.
Wie elk model één keer laat draaien, telt zulke kwetsbaarheden als gemist. Een lokale run kost ons ongeveer $0,65. Daardoor kunnen we elke test meerdere keren draaien en de bevindingen samenvoegen.
Wat de cijfers niet zeggen
De vergelijking is niet helemaal eerlijk. De lokale modellen kregen drie pogingen en de cloudmodellen één. In een enkele run was claude-opus-5 duidelijk beter dan qwen3.8, met 87,4% tegenover gemiddeld 71,3%. Wat drie samengevoegde runs van claude-opus-5 hadden opgeleverd, hebben we niet gemeten.
De benchmark laat zien dat een lokaal model met herhaling op hetzelfde niveau uitkomt als één run van claude-opus-5, voor een zeventiende van de kosten en zonder dat er data de server verlaat. De steekproef is klein: vier applicaties en 35 kwetsbaarheden, met een antwoordsleutel van onze eigen pentesters. De benchmark meet het terugvinden van bekende kwetsbaarheden en niet de fases die we aan mensen overlaten.
Wat hierna volgt
Op dit moment werkt alleen ons eigen securityteam met PenLocal. De komende maanden verhogen we met zowel frontier- en lokale modellen het aandeel kwetsbaarheden dat PenLocal vindt. Hoe dat gaat, lees je hier op het blog.
Daarna is het jouw beurt. We willen PenLocal binnenkort openstellen voor klanten:
- Zelf testen. Je maakt tests aan, start ze en volgt ze zelf.
- Met onze pentesters erbij. Zij beoordelen bevindingen en doen de fases waar menselijk oordeel het verschil maakt.
- Op je eigen infrastructuur. Op termijn draai je PenLocal ook volledig in eigen beheer, met je eigen modellen.
Eén pentest per jaar was altijd een budgetkeuze, geen securitykeuze. Met AI op eigen hardware vervalt die keuze.
Leg PenLocal naast je laatste pentest
Hebben we onlangs een applicatie voor je getest? Dan draaien we PenLocal op dezelfde applicatie en leggen we de twee rapporten naast elkaar. Je ziet dan wat de agent extra vond, wat hij miste en wat onze pentesters eruit filterden.
Neem contact op en noem PenLocal, dan plannen we de test met je in. Nog geen klant van Warpnet? Vul onderstaand formulier in en we bespreken of PenLocal bij jouw organisatie past.
Nieuwsgierig naar PenLocal?
Neem contact met ons op
Bronnen, geraadpleegd op 9 oktober 2026:
- NCTV, AI versnelt en vergroot de dreiging: nu handelen noodzakelijk, 24 september 2026
- Lin e.a., Comparing AI Agents to Cybersecurity Professionals in Real-World Penetration Testing, arXiv, december 2025
- DARPA, AI Cyber Challenge marks pivotal inflection point for cyber defense, 8 augustus 2025